让文章自己长出链接
之前每篇文章都是孤岛。相关文章靠标签算出来,但那是我猜的「读者可能想看什么」;真正的关系应该是「写的时候我确实引用了它」。
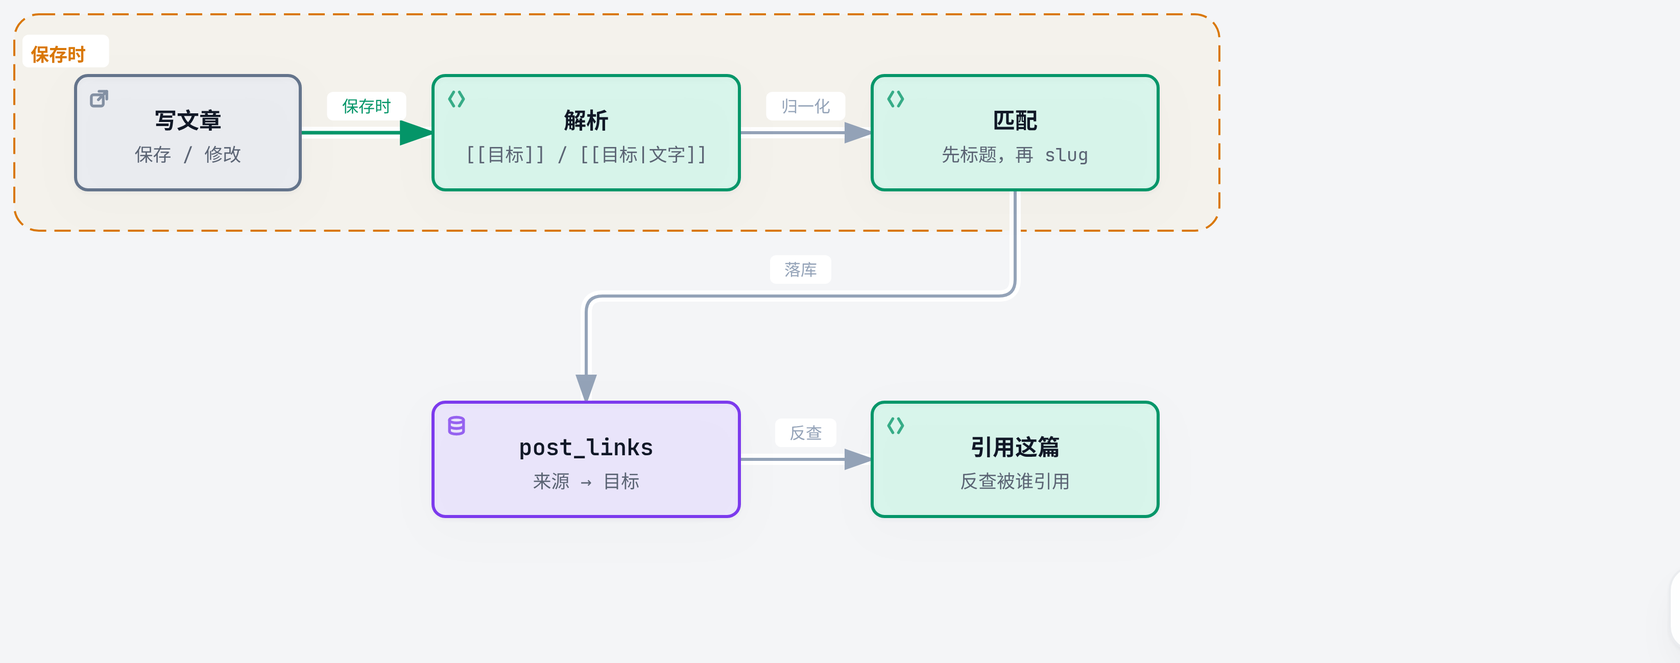
于是加了双链:正文里写 [[目标]],保存时建立链接,被引用的文章底部自动长出「引用这篇」。
这篇讲三个必须回答的问题——为什么不能在渲染时现扫、标题改了怎么对上、指向不存在的文章要不要报错,以及这套机制本身的代价。
为什么不能渲染时现扫
最省事的做法是渲染时用正则把 [[...]] 扫一遍。但它只能解决一半问题:
- 跳转要 slug。 我写的是标题(
[[月亮是两段圆弧]]),浏览器要的是/post/moon。这个映射要么每次查库,要么存下来。 - 反链要反查。 "谁引用了我"必须能按被引用方查询。渲染时现扫意味着每次都遍历所有文章正文。
所以落一张表:
CREATE TABLE post_links (
  from_id INTEGER NOT NULL,
  to_id   INTEGER,              -- 目标还没写时是 NULL
  target  TEXT NOT NULL,        -- 原文写的是什么
  PRIMARY KEY (from_id, target)
);
CREATE INDEX idx_pl_to ON post_links(to_id);
两个索引用处不同:from_id 是"改这篇文章时把它的出链重算",to_id 是"打开一篇文章时查谁引用了它"。
标题怎么对上
解析顺序只有两步,够用:
- 把目标当 slug 精确匹配;
- 不中,就当标题匹配(
lower(trim(title)))。
支持写成 [[slug|显示的文字]],因为有时候文章标题很长,正文里说"那篇讲月亮的"比复述标题自然。
发布或修改时做两件事:重算本文的出链,然后整体重连一次。第二件是关键——它把"之前指向还不存在的文章、现在那篇写好了"的悬空引用接上,也把"被删掉的文章"留成悬空。后者是有意的:删一篇文章不应该默默改掉别人正文里的字。
悬空引用不生成死链
指向不存在文章的双链,读者看到的是一段灰色虚线下划线的普通文字,点不动;作者自己看时,正文上方会多一行提示,说明哪几个目标还没写。
<span class="wikilink-missing" title="还没有这篇:数字花园">数字花园</span>
这样可以先埋链、后补内容——写系列文章时,第一篇里就能引用后面几篇。
前端只改文本节点
marked 出来的是 HTML 字符串。直接在字符串上做正则替换,会把代码块里的 [[memory]] 也换掉,还会误伤属性值。
所以先塞进一个游离的 div,再用 TreeWalker 遍历文本节点,跳过 code、pre、a 的子树:
while ((n = walker.nextNode())) {
  if (!n.nodeValue.includes('[[')) continue;
  if (n.parentElement?.closest('code, pre, a')) continue;
  hits.push(n);
}
每个命中的节点整段拆成 文本 + <a> + 文本 的片段再替换。这样代码块、行内代码、已有链接里的方括号全部原样保留。
两个事故
一、插入位置算错,吃掉了一行代码。
我用 Python 在 db.js 里插一组方法,锚点定位后写:
lines[start+1:start+1] = block.split('\n')
但后续步骤里我又用了 start + block.count('\n') 去取下一个位置——那个数比"插入的元素个数"大,于是第二段插入落到了 42 行之后,正好压在 posts.related 的循环体上,把
for (const t of pt) if (tags.includes(t)) score += 2;
换成了几行函数定义。node --check 报 SyntaxError: Unexpected token ':',行号指向 401 行——离我改的地方很远。
教训很直白:往数组里插 N 行,位移就是 N,不要去数换行符;而且改完之后必须看相邻上下文,不能只看语法检查过没过。
二、预览里的标题被判成不存在。
编辑器预览是即时的,但"标题 → slug"的索引要异步拉。第一帧渲染时索引还是空的,于是 [[关于内存的那些事]] 显示成"还不存在"——一秒钟后索引到了,页面却不会自己更新。
修法是在索引到达的回调里判断当前是不是预览态,是就重画一次:
previewLinkMap = map;
if (pane === 'preview') renderPreview();
验到什么程度
发一篇临时文章,四种写法各来一遍:
| 写法 | 结果 |
|---|---|
[[memory]] |
跳 /post/memory |
[[122 MB 的城市库]] |
按标题 → /post/geoip |
[[stars|星星那篇]] |
跳 /post/stars,显示"星星那篇" |
[[数字花园]] |
灰色虚线,不生成链接 |
再核四件事:post_links 落库内容对得上;目标文章出现"引用这篇 1"且位置在"接着读"之前;代码块和行内代码里的方括号原样;删掉临时文章后 post_links 自动清空。
最后一件值得记:删除文章时 post_links 的清理是从两端做的——删掉的可能是引用方,也可能是被引用方。前者删 from_id 的行,后者要把 to_id 置空、target 留着,等它被重新创建时自动接上。
这套机制的代价
写的时候要多想一步。 [[标题]] 要求你记得目标文章叫什么,或者故意留一个空引用等以后补。纯 Markdown 链接没有这个负担。
索引是写时重建的。 每次保存都要扫一遍正文、解析一次标题;全站重建要扫所有文章。文章几十篇时这叫「可忽略的成本」,几百篇时就得改成增量。
悬空引用会一直留着。 指向不存在目标的双链不生成死链,但也不会自动消失,只在正文里显示成灰色虚线。这是有意的——它记录的是「我打算写这篇」,删掉就丢了意图。代价是列表里会堆一批永远点不亮的名字。
最后一条其实是我最想保留的:那批灰掉的链接本身就是一份待写清单。