访问日志里,谁是人
访问日志刚做出来时,我每天看着「今日 700 多次访问」以为站点有点人气。把数据摊开才知道是幻觉:一周 1728 次请求,来自 820 个地址,其中执行过 JavaScript 的只有 73 次。
剩下的是爬虫、扫描器、链接预览器,以及我自己。
这篇讲怎么用一条判据把它们分开、怎么给每一类打标记并支持筛选,以及一个副作用:当「真人」这个数字终于可信之后,它变得很难看。
判据只有一条
试过好几个信号,最后只留一个能站得住的:这个请求有没有触发一次 XHR?
本站是单页应用。HTML 只是壳,真正的内容由 /api/posts、/api/categories、/api/auth/me 这些请求拉回来。也就是说:
- 真浏览器打开页面 → 必然产生 XHR;
- 爬虫、
curl、链接预览、漏洞扫描 → 只抓 HTML,永远不会执行 JS。
于是"有没有 XHR"几乎等价于"有没有一个 JS 引擎在跑"。它不能证明对面是人(无头浏览器也会跑 JS),但能干脆地排除掉绝大多数噪声。
一周的数据
| 类别 | 次数 | 怎么看出来的 |
|---|---|---|
| 扫描 | 808 | 路径在探测词表里,几乎全 404 |
| 页面 | 415 | 抓了 HTML 但没跑 JS |
| 爬虫 | 211 | UA 自报身份 |
| 本机 | 200 | 回环地址或自身出口 |
| 真人 | 73 | 跑了 JS |
| 命令行 | 21 | curl / node / 无头浏览器 |
几个让我确信判断没错的细节:
- 820 个地址里,728 个一次 JS 请求都没有;
- 537 个的第一条请求就是
/wp-json/wp/v2/users/me——WordPress 的经典用户枚举接口,说明这些是拿现成字典在扫; - 640 个只来过一次,再也没出现;
- 有个 IP 在 32 分钟里换了 32 个不同的 User-Agent,全在打同一个路径;
- 荷兰三个地址持续 4 小时 44 分,节奏规律到可以当节拍器。
人工抽了 20 个
自动化判据最怕"看起来对"。所以随机抽 20 个被判为真人的 IP,逐个查 UA、请求序列、停留时长。
20 个里 19 个是清晰的真人行为:先 /,再 /api/posts,然后 /api/categories,进文章,有几秒到几分钟的间隔。剩下 1 个是带 JS 引擎的渲染型抓取,但它的请求序列是"首页 → 立刻退出",没有滚动或二次点击。
结论:判据偏保守——它可能把某些真人算成"页面"(JS 被拦、禁用、或用纯文本浏览器),但不太会把机器算成人。
再过一周
这套标记跑了一周之后,我又拉了一次同样的表。两次都是「最近 7 天」,可以直接比:
| 类别 | 上一周 | 这一周 | 变化 |
|---|---|---|---|
| 扫描 | 808 | 1400 | +73% |
| 页面 | 415 | 1022 | +146% |
| 爬虫 | 211 | 640 | +203% |
| 本机 | 200 | 550 | +175% |
| 真人 | 73 | 76 | +4% |
| 命令行 | 21 | 18 | −14% |
| 合计 | 1728 | 3706 | +114% |
总请求翻了一倍多。真人多了 3 次。
更清楚的是地址数:这一周 1131 个独立地址里,产生过真人行为的只有 10 个。
上一周的比例是 4.2%,这一周是 2.1%。分母在涨,分子没动。
这不是「流量变差了」,这是「流量从来就不是我以为的那种」。翻倍的那部分 100% 是机器——扫描器在按行业字典轮询,爬虫在按自己的节奏重抓,还有一些地址是我自己在跑测试。
顺带一个观察:page 类(抓了 HTML 但没跑 JS)增长最快,+146%。这类里最大的一块是链接预览——把地址贴进聊天软件,对方服务端会来抓一次 og 标签。贴得越多,这一类涨得越快。它们不是读者,但也不是攻击,所以单独留着不合并。
五类标记怎么排
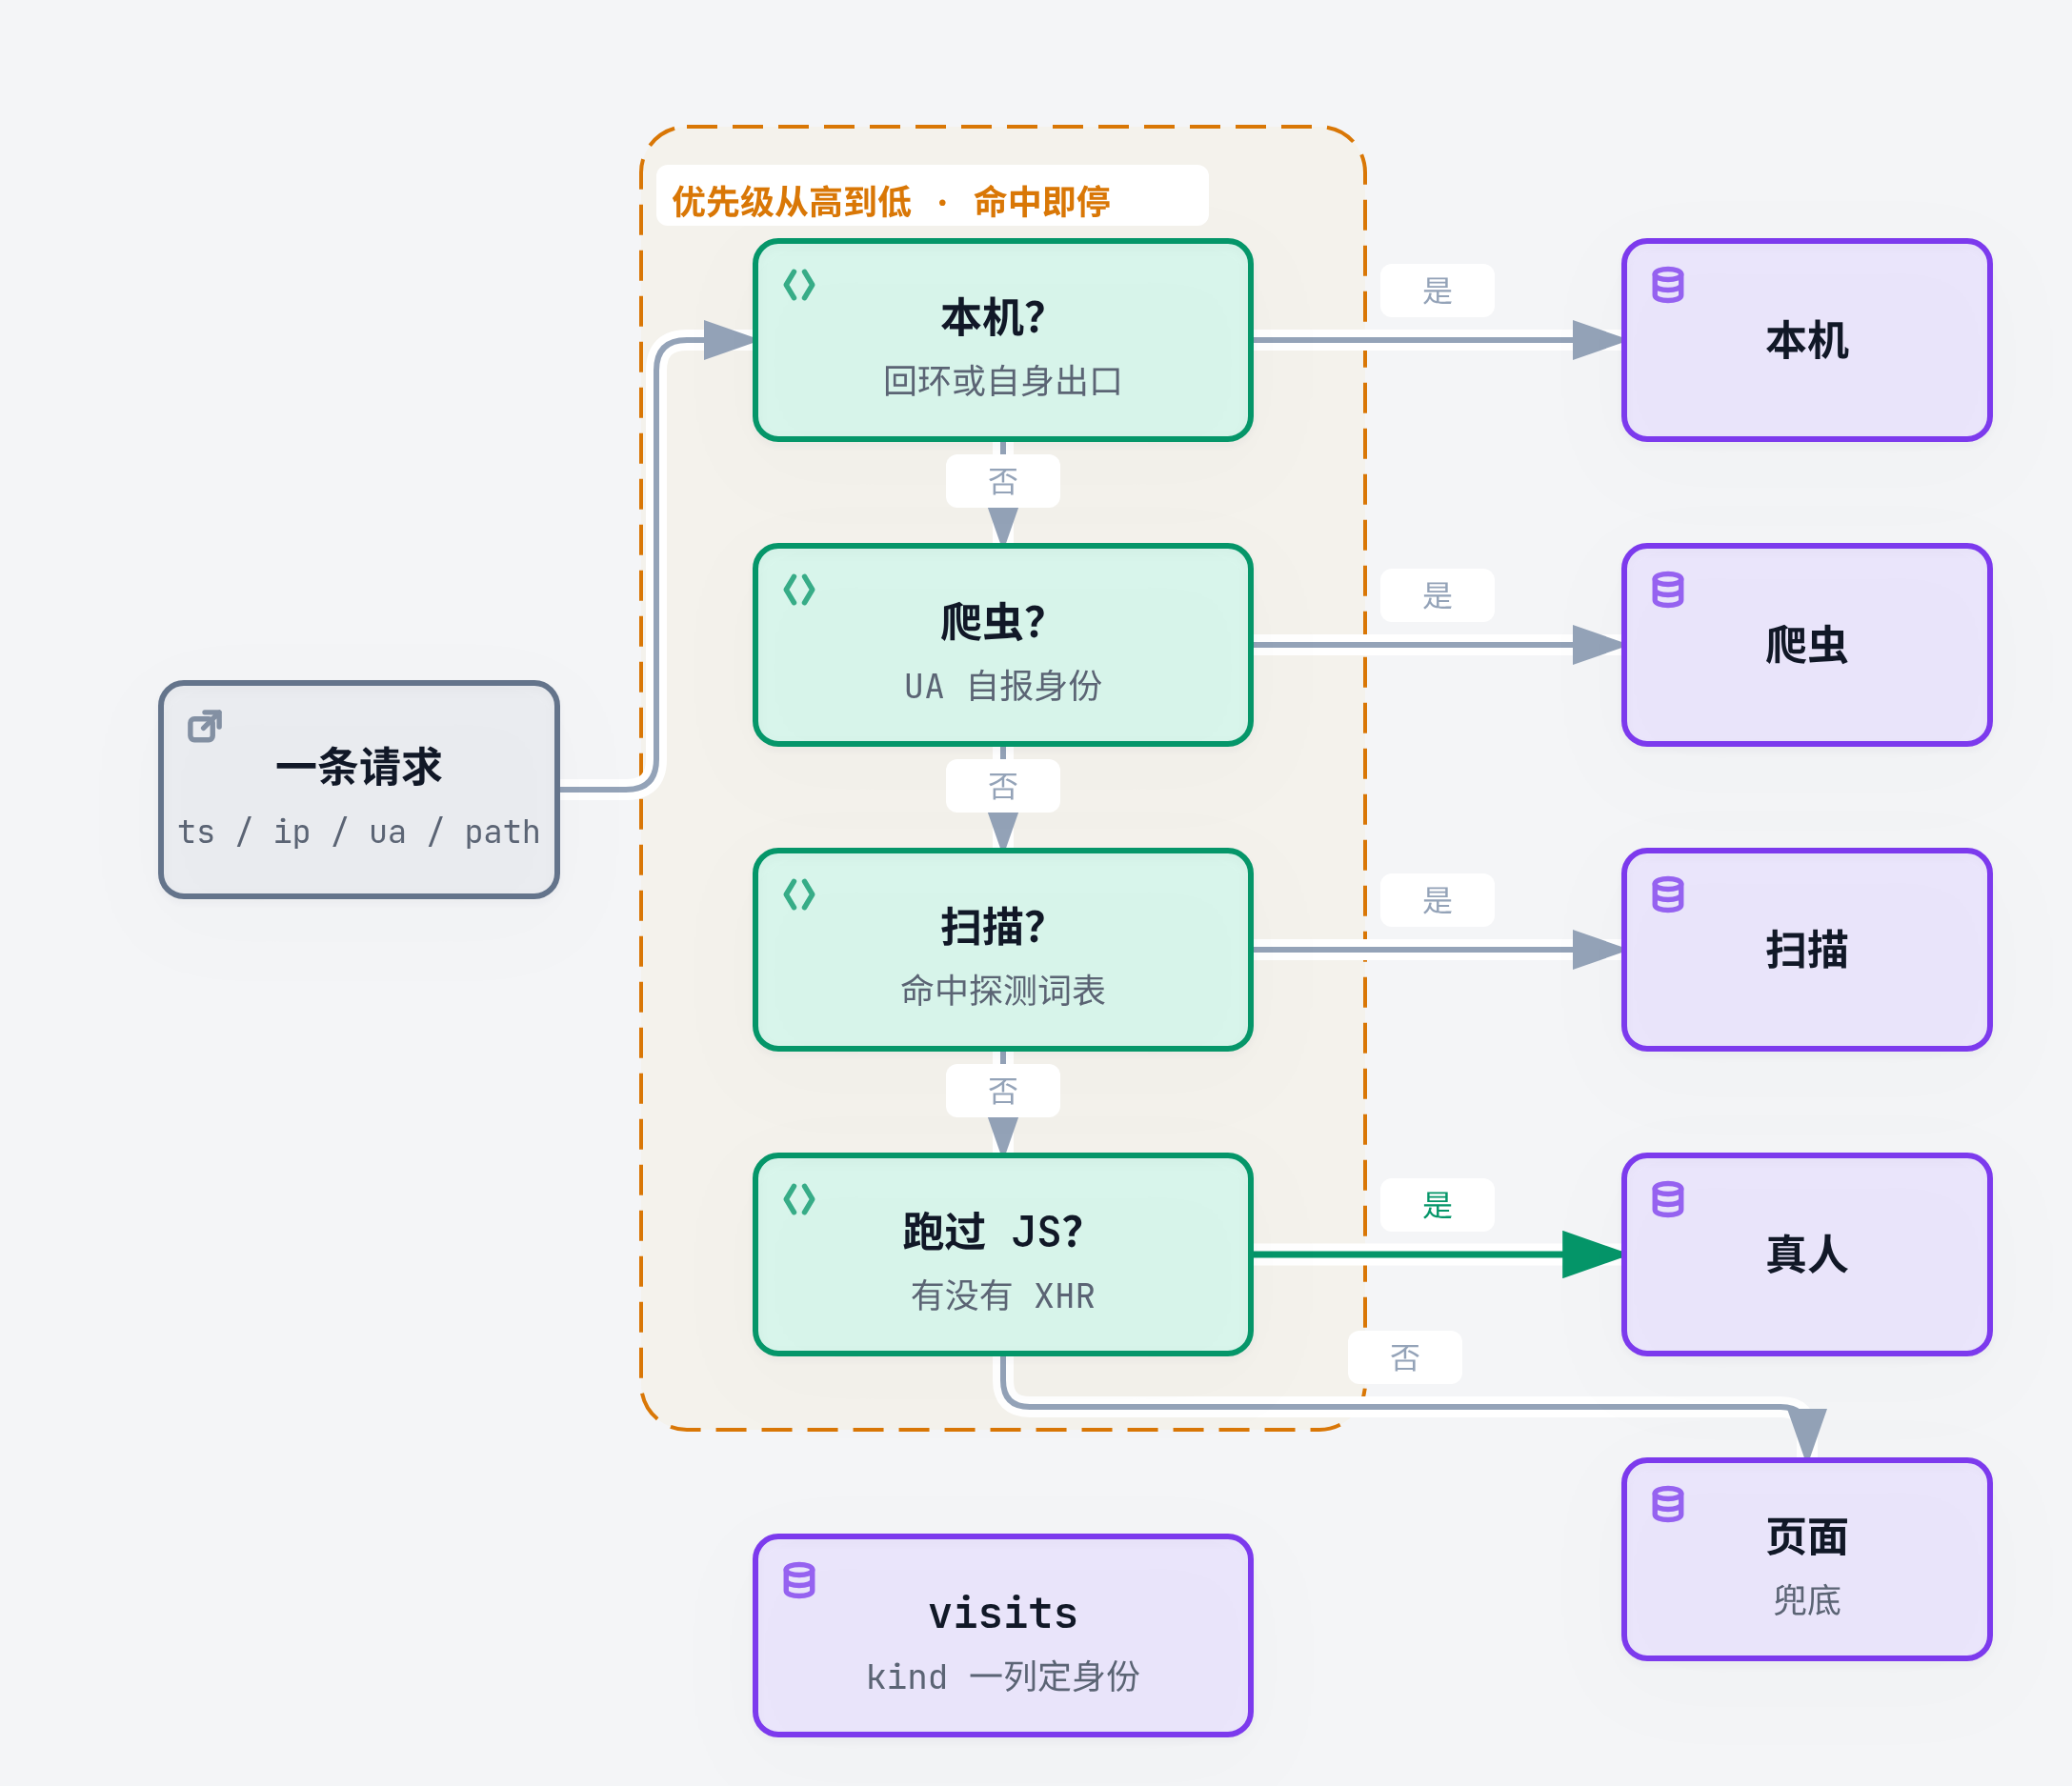
一条请求只打一个标签,优先级从高到低:
本机 > 爬虫 > 扫描 > 真人 > 页面
顺序有讲究:
- 本机排第一,因为回环地址的 UA 五花八门(
curl、无头浏览器、我自己写的脚本),不先摘掉会污染所有统计; - 爬虫排第二,因为有些爬虫也会跑 JS(Googlebot、AhrefsBot 用渲染引擎),它同时满足"真人"的条件,但身份已经自报了;
- 扫描排在真人前,因为一个跑了 JS 但满屏都在试
.env的客户端不可能是读者; - 真人排在页面后是反的?不,正好相反——有 XHR 才配叫真人,只有 HTML 的一律算"页面"。这条同时兼作兜底。
探测词表决定"扫描"这一档。目前覆盖 .env、.git、.svn、.hg、phpinfo、wp-login、wp-json、xmlrpc、.aws、vendor/phpunit、actuator、/debug 等,加上"路径不在已知路由白名单里且返回 404"这一条。
为什么值得做这件事
因为统计的意义取决于分母。
没做标记之前,面板上写"今日 700 次访问",看起来像有人气;分层之后同一天的真实数字是 73,而且这 73 里大部分是我自己在调试。
知道自己没有读者,比以为自己有读者有用得多。它至少解释了为什么每一篇的浏览量都停在个位数,也把"要不要继续写"这个问题从情绪问题变成了事实问题。
顺带修的两个界面问题
表格在手机上碎掉。 六列塞进 390px,IP 列写死 192px,路径列被压到 49px,URL 逐字竖排、一行高 229px,相邻列的字还叠在一起。最后是靠横向滚动解决的:table-layout: fixed + 各列固定宽 + 表格 min-width: 700px,让"时间 / IP·地区 / 访客"始终可见,后面几列滑出来看。
那次还挖出一个潜伏很久的 bug:状态列是 position: sticky; right: 0 钉在右边,背景写的是 var(--bg-card)——而这个变量全站只有引用、从来没有定义。于是它透明,底下的文字直接透出来跟状态角标重叠。补上变量定义后,顺带让"相关文章"卡和状态卡也有了底色。
现在的样子
四个数字卡里,"区间访问"跟随筛选,"今日访问"永远显示全部——因为"今天有多少人来了"和"今天有多少人从美国来"是两个问题,混在一起会让人误读。
每行左边一个彩色小徽标(本机/爬虫/扫描/真人/无 JS 痕迹),下拉框能按类别筛,统计卡和两个排行都跟着变。这样想看"真人到底看了什么",选一下就好。
这个指标的局限
执行了 JS 不等于真人。 现代爬虫(Google、Ahrefs)会执行脚本,所以它们也会落进「真人」那一栏。要再细分只能看行为,比如有没有滚动、停留多久。
同一出口算一个地址。 走运营商大内网时,一整个小区可能共用一个地址,「独立 IP」会严重低估。
它只回答「有没有真的执行 JavaScript」,不回答「这人是谁」。 后者需要 cookie 或登录,两者都涉及隐私取舍——这也是标记只做到「类别」这一层就停了的原因。