这个站是怎么搭的
一台 1 GB 内存的小机器,二十多篇文章,零运行时依赖——这个站就是这么搭起来的。
没有框架、没有构建步骤、没有 ORM。数据库用 Node 内建的那一个,前端是一组字符串模板函数——起初全在浏览器里跑,后来把首屏搬到了服务端(见最后一节),静态资源靠内容哈希做缓存校验。
这篇写给想用最小成本维护一个长期站点的人:为什么这么选、数据长什么样、哪几个决定事后看是对的、哪些是妥协。文中数字都是线上实测,不是估算。
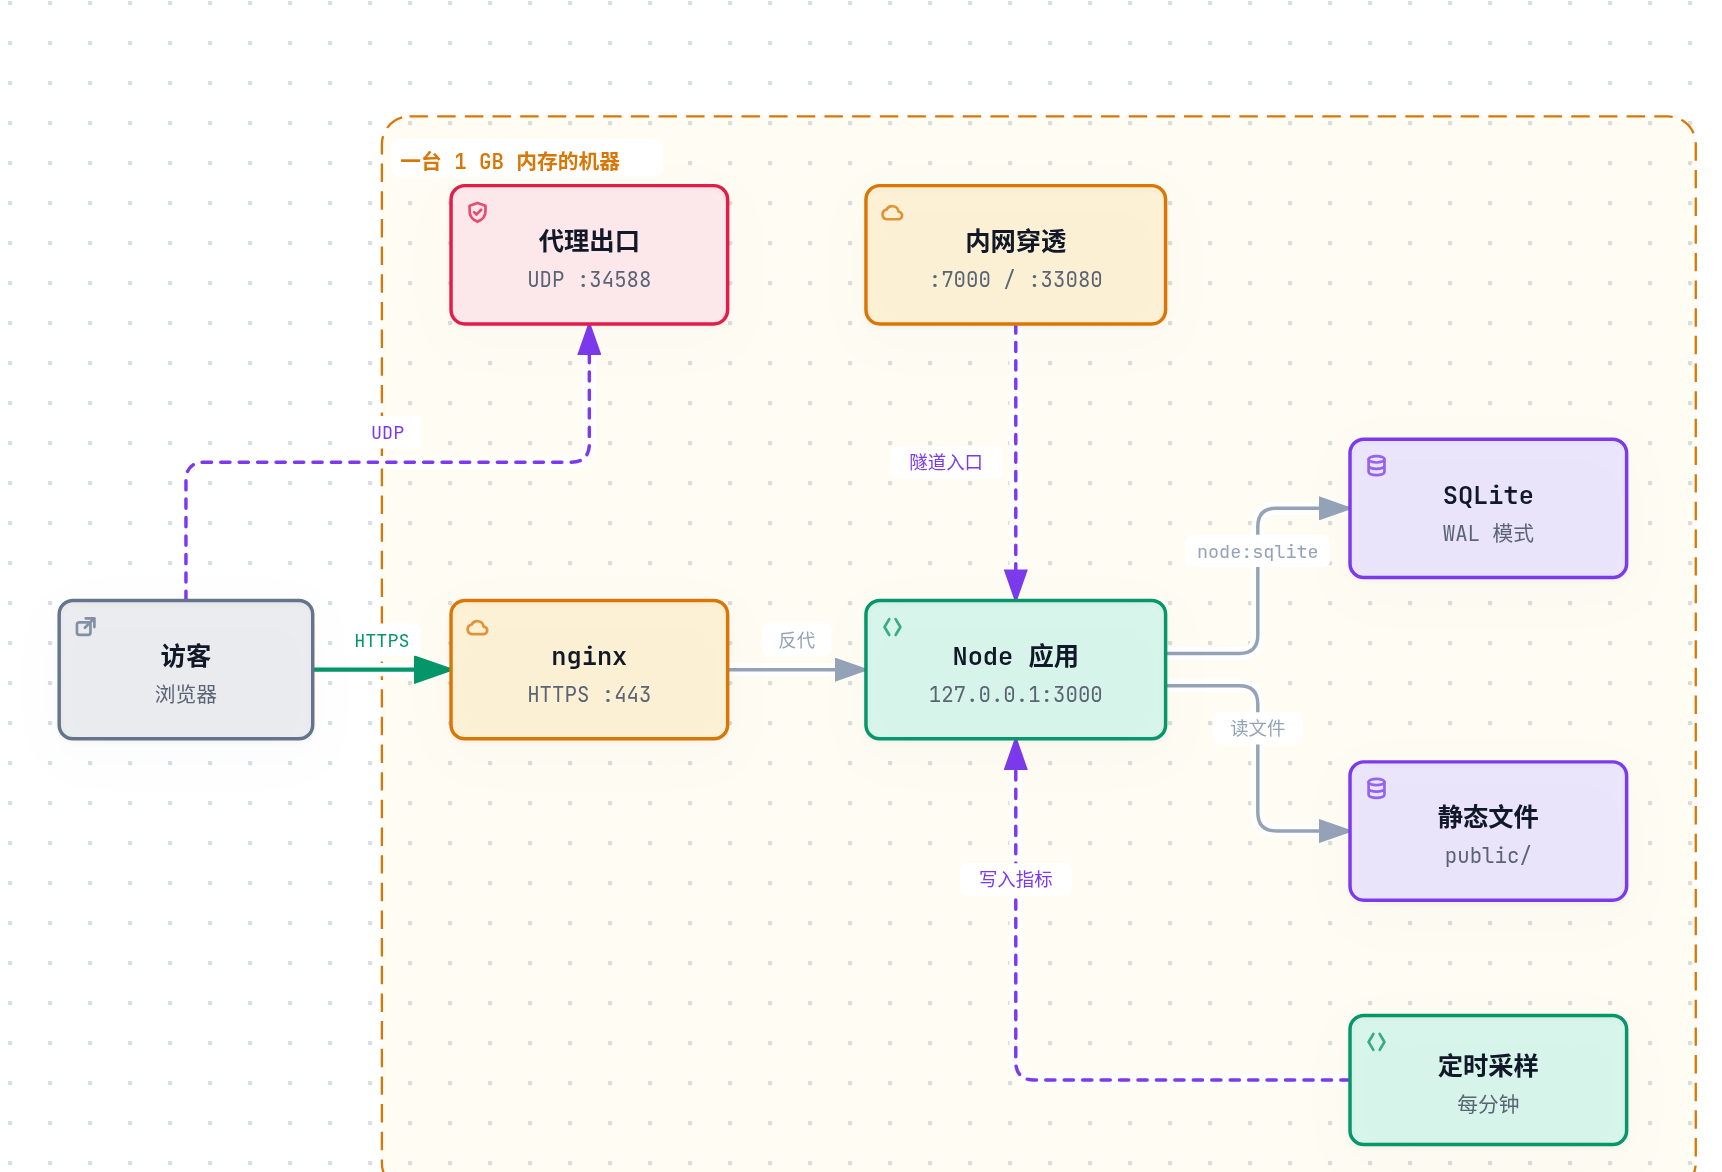
运行时
两个硬约束决定了选型:机器只有 1 GB 内存,以及不想为了一个数据库驱动装一整套构建工具链。
前者排除了大部分「每个进程都要几兆运行时」的方案;后者决定了数据库怎么选。
选较新的 Node 不是为了追新,是为了 node:sqlite——22.5 起内建,直接调 SQLite,不需要编译原生模块。better-sqlite3 这类要现场编译的方案,在一个刚装好的系统上意味着先装编译器、头文件、Python 构建后端。
数据层
十五张表,全部 CREATE TABLE IF NOT EXISTS,启动时幂等建。
| 表 | 内容 |
|---|---|
posts |
文章,含草稿位、分类、作者、浏览量 |
comments |
评论,嵌套用父 id 指向自己 |
users / sessions |
账号与会话令牌 |
categories |
分类 |
rate_limit |
限速计数(动作 + 地址哈希 + 时间窗) |
visits |
访问日志,含设备、地区、运营商 |
links |
短链接 |
metrics / incidents |
监控采样与故障事件 |
post_links |
双链索引:哪篇引用了哪篇,写文章时重建 |
post_revisions |
文章历史快照,每篇留最近 50 份 |
activity |
操作日志:谁在什么时候动了什么 |
game_saves / game_saves_history |
游戏云存档,以及它的小范围历史 |
开启 journal_mode=WAL:读写可以并行,崩溃恢复更干脆。代价是多两个附属文件(-wal、-shm),备份时不能只拷主库——这一点很容易忘。
分类索引在数据迁移之后才建,因为迁移要加列,先建索引会挡路。
后端
没有框架。路由是一条 if-else 链,接口数量还没多到让它失控。
请求体读取有个 256 KB 的硬上限,超出直接 413,不读到内存里再判断。
密码用 scrypt:N=16384, r=8, p=1,64 字节密钥,存储格式是 scrypt$N$r$p$salt$hash(把参数一起存进去,将来调参不影响老密码)。校验用定长时间比较。用户不存在时也跑一次哈希,避免用响应时间判断账号是否存在。
会话令牌 30 天有效,Cookie 带 HttpOnly、SameSite=Lax、Secure。
前端
原生 JavaScript,没有框架,没有构建步骤。改完刷新就生效。
路由是自己写的 pushState 分发,约十几个页面。每个页面函数负责渲染并绑定事件,切换时把上一页留下的定时器、浮层、DOM 外的节点清掉——目录侧栏和监控大屏的自刷都吃过这个亏:挂到容器外面的节点不会被覆盖渲染清掉,进第二篇带目录的文章时就叠了两份。
Markdown 用 marked + DOMPurify,两个库都是本地文件,不走 CDN。白名单只放常用标签和属性,链接协议只允许 http/https/mailto。
预览和正文共用同一个渲染函数。所以「预览里对的,发出来一定对」,不存在两套实现的漂移。
零散的几个决定
搜索不用全文索引。中文两字查询在三分词的分词器下完全失效(需要至少三个字符),退回关键词拆分加权重排序:标题命中 3 分、摘要 2 分、正文 1 分,多关键词之间是 AND。在几千篇的量级下够用,而且行为可预测。
目录从已经渲染好的正文里现抓标题,不做二次解析。这样目录和正文永远一致,代价是必须等渲染完成才能算——所以它比正文晚一帧出现。
RSS / sitemap / robots 都是实时生成的,不是构建产物。文章改了不需要重新发布任何文件。
静态资源用内容哈希做 ETag,配 Cache-Control: no-cache(缓存但每次校验)。改一个字,哈希就变,浏览器立刻拿到新的——这个站最早吃过亏:HTML 更新了但脚本还在缓存里,点了首页链接直接 404。
gzip 在网关层做,对 JSON 和文本生效,图片不压。
依赖
运行时依赖:零。
不是刻意追求,而是每个功能都找到了足够小的实现方式:地理库用内嵌的解析器(九个文件、104 KB);邮件客户端手写 SMTP;监控是定时器拉起的一次性进程。
代价是每个功能都要自己写、自己调,边界情况也只能自己想。用现成的库,边界是别人踩过的坑;自己写,边界是你的想象力。
好处是四年后回头看,不会有任何一个功能因为上游弃坑而突然失效。
资源
| 项 | 实测 |
|---|---|
| 常驻内存 | 63 MB(含 128 MB 地理库的不常驻) |
| 磁盘占用 | 5.1 / 19 GB |
| 冷启动到可服务 | < 1 秒 |
| 一篇文章渲染 | 一次性,无构建 |
这套东西的边界
说清楚它不适合什么,比说它好用更有用。
内容量。 文章几百篇之后,列表查询和中文搜索都会开始难受——现在的实现是全表扫加内存排序,连索引都没建。到这个量级需要引入索引和分词方案,那是另一套东西。
协作。 除管理员之外没有别的角色,没有审核流、没有定时发布、没有草稿协作。不是漏做,是没这个需求;真要做,加起来比现在整个后端还多。
可用性。 数据库和应用同机,备份是每天一次的逻辑导出。真出硬件问题最多恢复到昨天。对一个博客够用,对别的用途不够。
抽象的余地。 路由是一条 if-else 链,接口到五十个就该拆。在那之前,一条链比三层抽象好读;过了那条线,它会开始碍事。
服务端出 HTML
早期首页返回的 HTML 里只有一个标题,文章列表全靠客户端拉回来渲染。这是单页应用的标准做法,但有两个代价:慢网下先白一下,搜索引擎抓到的是空壳。
后来改成服务端先渲染:
- 文章页:正文完整写进 HTML,客户端接管后只挂事件
- 首页:前 12 篇写进 HTML,接管后补齐成 20 篇
- 404:服务端生成完整页面(标题、搜索框、分类、最近文章),但状态码仍然是 404
HTML 从 3.5 KB 涨到 10.7 KB,gzip 后 2.9 KB。
代价是要维护两份渲染逻辑——服务端一份、客户端一份。这是这个方案唯一的真成本。
所以规则定死:服务端只渲染静态结构,不碰任何依赖交互的状态。客户端的渲染函数复用同一套 DOM 结构,接管时结构一致就直接挂事件,不一致才重绘。
否则会看到页面「跳」一下。那种跳,比多等两百毫秒更难受。
顺带一个不那么明显的收益:404 页从纯文本三个字节变成完整页面之后,从搜索引擎点进来落空的访客有路可走了——搜索框、分类、最近文章都在。