每分钟采一次样,然后闭嘴
站点挂过一次半个多小时,是去看别的东西时才发现的。所以做了监控。
这篇记几个关键决定:为什么不用常驻进程、内存该看「可用」还是「空闲」、连续几次失败才算真的挂、以及一个差点漏掉的阈值 bug——它让某类告警永远不会触发。
如果你也要给一台小机器加告警,这几条能省掉我踩过的坑。
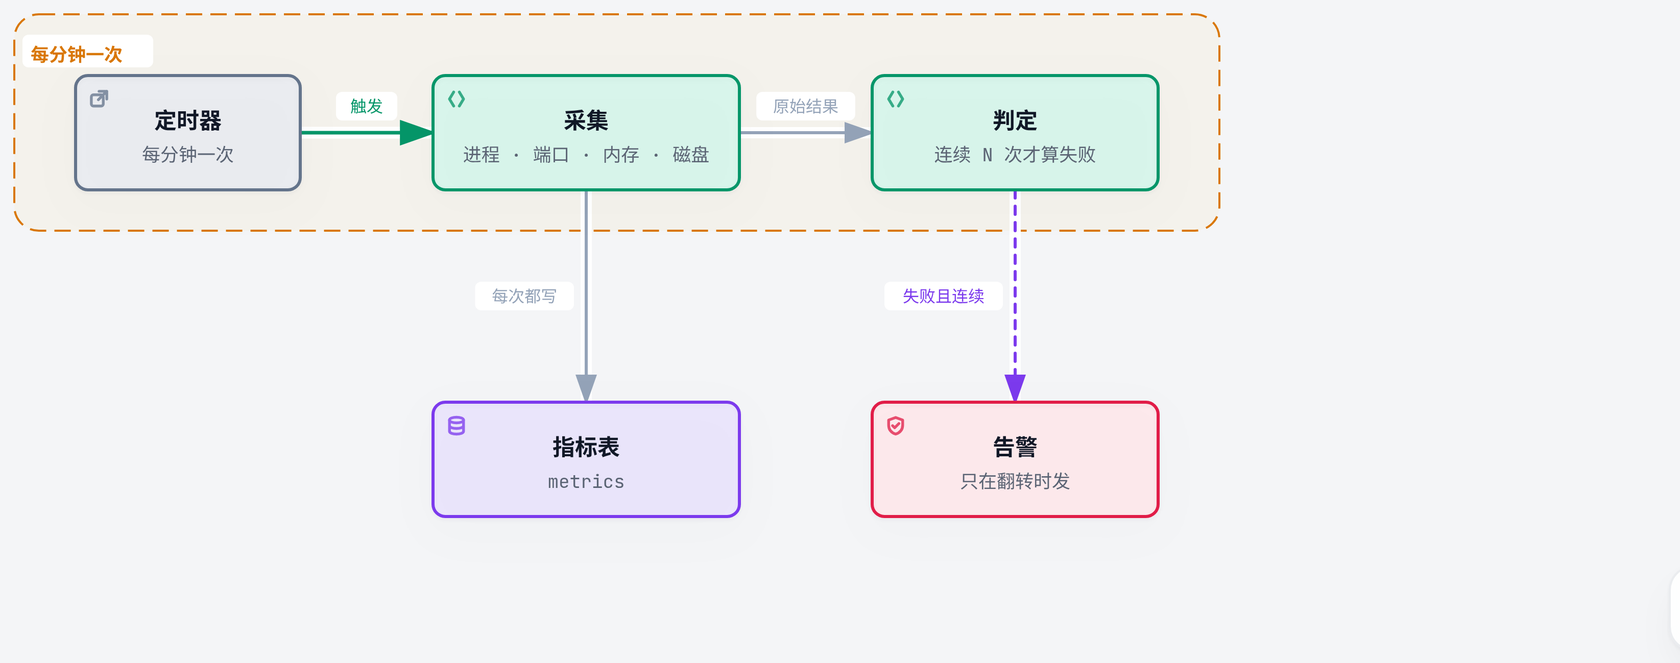
不做常驻进程
监控最自然的形态是常驻进程:循环、睡眠、采集、报警。
没这么做,理由是三条:
- 常驻要占三五十兆常驻内存,而它监控的对象里恰好包括「内存够不够」;
- 它自己崩了就没人知道——因为负责发现问题的那位已经不在了;
- 修它的时候要重启它,正好在需要它的时刻失去监控。
改成一次性进程,由定时器每分钟拉起:
[Timer]
OnBootSec=45s
OnUnitActiveSec=60s
AccuracySec=5s
Persistent=false
实测单次 CPU 1.152 秒、峰值 RSS 20.8 MB,跑完退出,内存全部归还。
Persistent=false 是有意的:错过的采样不该补跑。监控关心的是「现在」,回补一条十分钟前的记录只会污染曲线。
内存要看可用,不是空闲
第一版判断内存紧不紧张用了空闲内存,结果永远报警。
在一台跑了一阵的 Linux 上,MemFree 常年接近零——页缓存会把空闲内存吃满,这是设计如此,不是问题。
换成 MemAvailable(把可回收的缓存算回来)才正常。这个数字才是「还能再申请多少」的答案。
指标语义选错,比阈值选错更糟:一个整天误报的监控,两次之后就被无视了,等于没有。
磁盘用 fs.statfsSync('/') 现算,不解析 df 的输出——那个输出的人类可读格式一变就得跟着改。
怎么判断一个进程还活着
有个第三方服务,非特权用户用 ss -p 看不到端口归属(内核不把 socket 到 pid 的映射给非特权进程),所以没法「查端口属于谁」。
拆成三个都能观测到的事实:
const alive = pgrep(svc.name)              // 进程名在
           && ssWithPort(svc.port)         // 端口在监听
           && svc.port === portFromConfig; // 端口号和预期一致
三条同时成立才算活着。不优雅,但每条都是确实能读到的。
端口从配置文件读,不从进程命令行猜——那个服务支持自动换端口,硬编码会误报。
连续两次才算失败
第一版是「一发现异常就发信」。
结果是网络抖一下收到两封:一封说挂了,一封说好了,间隔四十秒。这种信看两次就没人看了。
改成按连续次数判定:
| 项 | 需要的连续失败次数 | 理由 |
|---|---|---|
| 站点进程 / 网页 / 代理 | 2 | 偶发超时很常见 |
| 内存 / 磁盘 | 3 | 这两个指标本身变化慢 |
| 响应变慢 | 5 | 慢的判定最主观,最容易抖 |
恢复则立刻生效:失败可能是偶然,成功不可能是偶然。
再加一层:同一种故障 30 分钟内反复开关超过 2 次,只发第一次通知。
差点漏掉的 bug
上线两天后自查,发现「响应变慢」这一类告警永远不会触发。
代码是这样的:
const rows = S.recentRows(cfg.failThreshold + 1);  // 取 3 条
const n = streak('slow', rows, cfg);               // 但 slow 的阈值是 5
if (n >= 5) open('slow');
取样条数按「最短的那个阈值」算的,而响应变慢的阈值是 5。三条样本永远凑不出五连败。
这种 bug 不报错、不崩、也不产生任何异常日志。它的表现是**「从来没出过这种问题」**——而实际上它从上线起就没在观察。
修法是把取样条数取成所有阈值里的最大值,并且写死一个下限:
const rows = S.recentRows(Math.max(cfg.failThreshold + 1, 6));
探活把自己的统计搞坏了
监控每分钟发三个请求:直连应用端口、经网关、走公网域名绕回来。
三个都会写进访问日志。一天 4320 条,于是那个「今日访问 2170 次」的数字里绝大部分是自己。
修法很轻:探针带一个自定义请求头,记录函数看到就跳过。
代价是这个头必须由网关透传,否则走网关的那条探针会丢掉它。改完把那批自访问记录一次性删掉(带确认条件,只删本机加命令行 UA 的那些)。
手写邮件客户端
发信本来想引库,最后手写了——和数据库驱动同样的理由:为一件很窄的事引一整棵依赖树。
协议本身不长,花时间的是几个细节:
- 主题里的中文要按 RFC 2047 编码成
=?UTF-8?B?...?=,否则很多客户端显示乱码; - 正文一律 base64,一次避开三类问题:八位字符、以点号开头的行(会被当成结束符)、单行超长(上限 998 字符);
- 多行应答要靠分隔符判断「结束没有」。服务端会回
250-xxx若干行再接250 xxx,只认「三位数字加空格」的那一行; - 端口 465 是隐式 TLS(连上就握),587 是明文连上再
STARTTLS,两条路径都要走。
不支持附件、抄送、DKIM——告警邮件用不到。
现在的样子
采集写入两张表:metrics(一行一次采样,含负载、内存、磁盘、三个探针的结果码与耗时)和 incidents(一次故障一行,开时间、闭时间、已通知标记)。
大屏上四张卡:整体状态、24 小时可用率、平均响应(本机与外网分开)、最后一次采样。下面是响应曲线、24 个小时格、最近事件。
保留 30 天,每次采样顺手清理过期行。
页面上那个可用率 84% 是真实的——我自己重启服务的次数都算在里面,没有做排除。
这套东西的边界
它不能替你看。 告警能说「502 了」,说不出「文章读起来别扭」。可用率 100% 和站点有用是两件事。
阈值是猜的。 内存 45%、磁盘 80%、响应 3000 毫秒——这三个数没有理论依据,是先跑一周看分布再定的。换一台机器就得重定。
采样间隔就是盲区。 每分钟一次,意味着 59 秒内的抖动会被折叠成一条记录。要更细就得更密的定时器,而定时器本身也消耗资源。
可用率是保守的。 大屏上那个 84% 把服务重启的时间都算了进去,没有做排除。美化它很容易,但那样它就不再是可信指标了。